两套模型系统同一个本地愿景
StartLux 以两套模型系统探索本地智能:StartLux-Decision 专注快速判断与按需思考;StartLux-27B 面向多步规划、工具调用与任务执行,让不同任务找到合适的模型能力。
在下方了解两款模型SYSTEM 2StartLux-27B
SYSTEM 1DECISION
LOCAL INTELLIGENCEStartLux
从模型定位、公开测试到本地运行价值,了解 StartLux 如何让大模型真正进入用户自己的设备与环境。
StartLux 以两套模型系统探索本地智能:StartLux-Decision 专注快速判断与按需思考;StartLux-27B 面向多步规划、工具调用与任务执行,让不同任务找到合适的模型能力。
在下方了解两款模型v1.1 · 27B · Instant
Hugging Face 上的
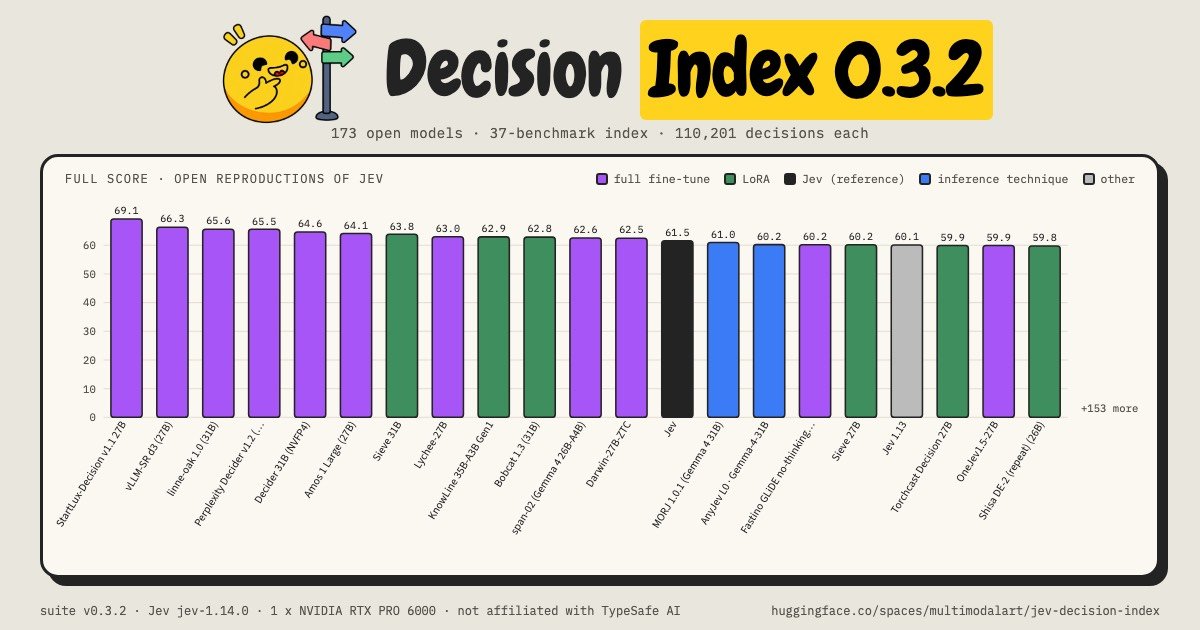
Decision Index 0.3.2 文本榜第一
综合分 69.12
榜单快照
V1.0-27B-Preview
中国信通院 MCP 专项测试
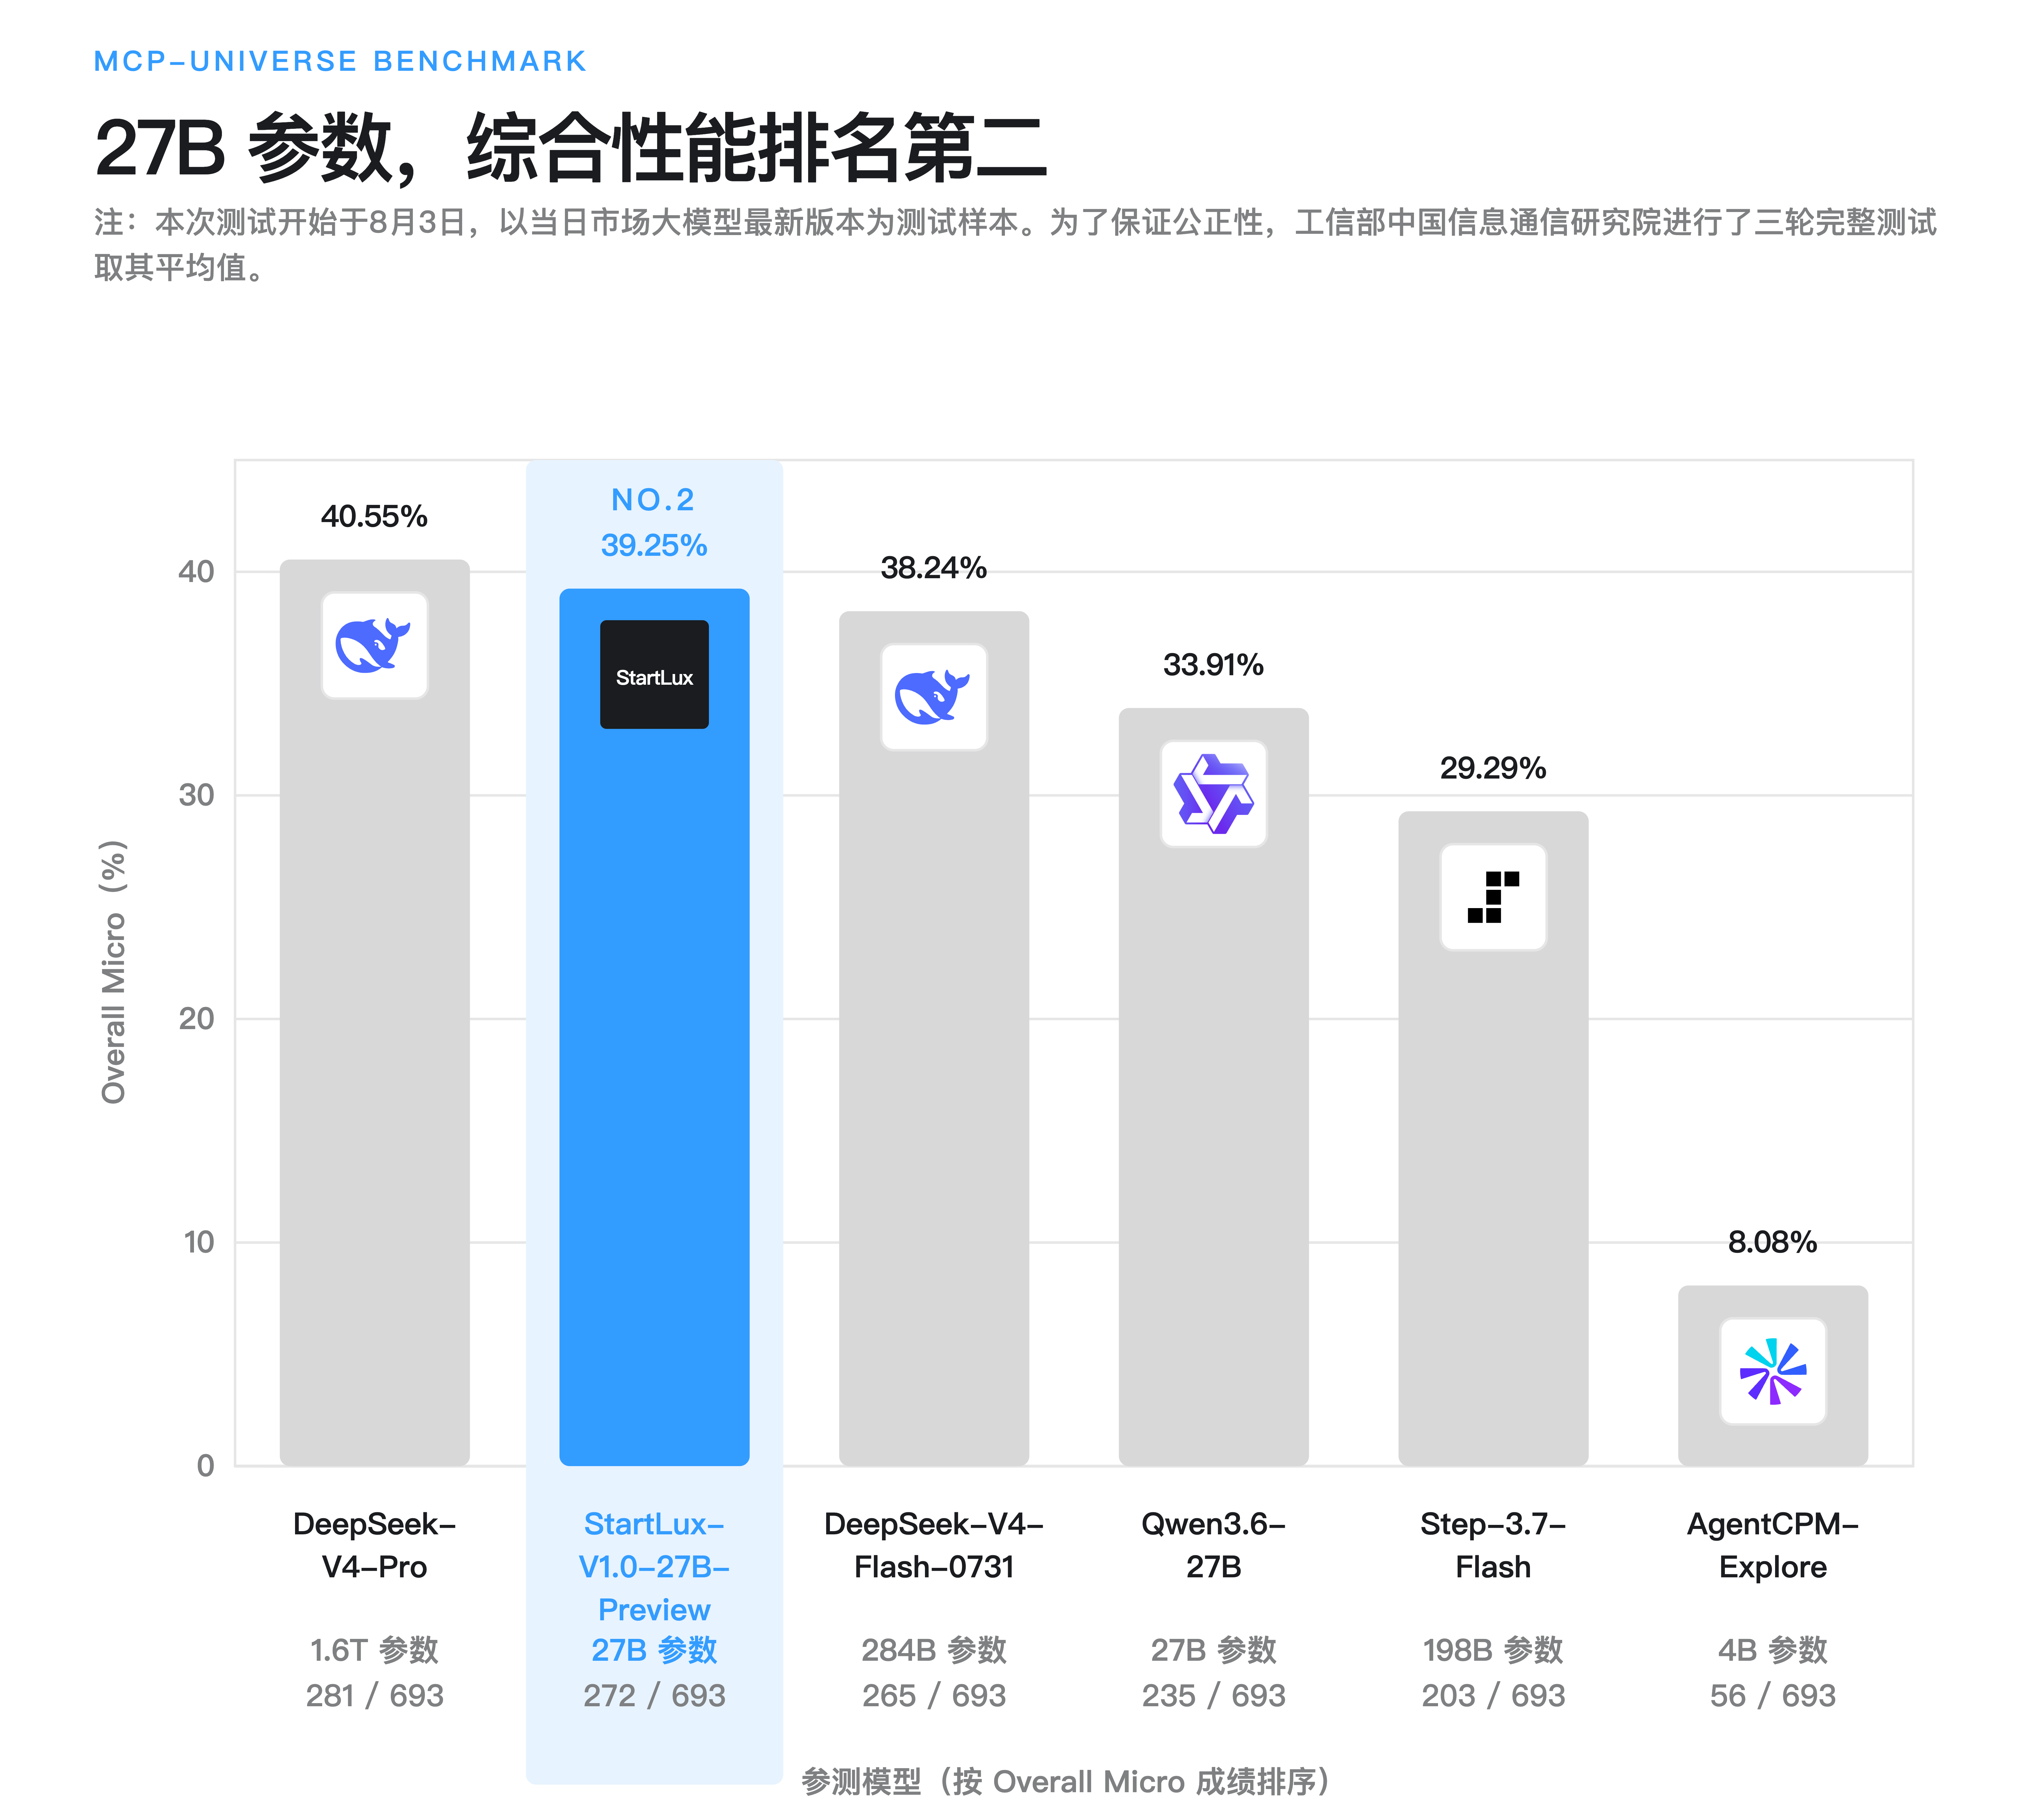
六款参测模型中,综合排名第二
Overall Micro Pass@1 39.25%
评测时间
本地大模型让重要数据无需持续上传云端,也让长期使用成本、运行环境和模型能力掌握在用户自己手中。本地不只是一种部署方式,更意味着隐私、效率与自主控制权。
DECISION MODELS
StartLux-Decision 直接给出候选选项的概率。并提供了一个双模型矩阵:直接给出候选选项的概率。Instant 一次计算完成判断;AutoThink 在不确定时进一步推理,让思考用在需要的地方。
一次计算,直接判断
有把握直接输出,不确定时进一步推理
Hugging FaceDecision Index 0.3.2 文本榜
文本榜综合排名 · 174 个榜单条目
左右滑动,对比全部八款模型 →
公开测试 20% · 同能力私有测试 50% · 新领域私有任务 30%
数据快照 2026.10.16 · 私有分数经等值映射后加权 · = 表示并列名次
来源:Hugging Face 上的 Jev Decision Index
LOCAL AGENT MODEL · 27B
经过三轮测试,StartLux-V1.0-27B-Preview 的全部有效任务合并后的总体通过率(Overall Micro Pass@1)为 39.25%;我们取三轮 Macro 结果的算数平均值,得出 Overall Macro Pass@1 为 38.89%。两项指标均位列六款参测模型第二。
注:本次测试开始于8月3日,以当日市场大模型最新版本为测试样本。为了保证公正性,工信部中国信息通信研究院进行了三轮完整测试取其平均值。
左右滑动,对比全部六款模型 →
| 测试领域MCP-UNIVERSE | DeepSeek- V4-Pro1.6T · A49B |
StartLux-V1.0- 27B-Preview27B · DENSE |
DeepSeek- V4-Flash284B · A13B |
Qwen3.6- 27B27B |
Stepfun- 3.7-Flash198B · A11B |
AgentCPM- Explore4B |
|---|---|---|---|---|---|---|
| Overall MicroPass@1 | 40.55%281/693 | 39.25%272/693 | 38.24%265/693 | 33.91%235/693 | 29.29%203/693 | 8.08%56/693 |
| Overall MacroPass@1 | 40.03% | 38.89% | 37.46% | 32.49% | 27.46% | 7.08% |
| Web Search165 runs | 47.27%78/165 | 42.42%70/165 | 56.36%93/165 | 41.82%69/165 | 44.85%74/165 | 9.09%15/165 |
| Location Navigation135 runs | 32.59%44/135 | 33.33%45/135 | 31.85%43/135 | 28.89%39/135 | 31.11%42/135 | 9.63%13/135 |
| Financial Analysis120 runs | 68.33%82/120 | 68.33%82/120 | 50.00%60/120 | 59.17%71/120 | 41.67%50/120 | 19.17%23/120 |
| Browser Automation117 runs | 28.21%33/117 | 28.21%33/117 | 13.68%16/117 | 18.80%22/117 | 7.69%9/117 | 2.56%3/117 |
| Repository Management99 runs | 18.18%18/99 | 17.17%17/99 | 27.27%27/99 | 18.18%18/99 | 13.13%13/99 | 2.02%2/99 |
| 3D Design57 runs | 45.61%26/57 | 43.86%25/57 | 45.61%26/57 | 28.07%16/57 | 26.32%15/57 | 0.00%0/57 |
淡蓝线框为 StartLux-V1.0-27B-Preview;浅色单元格表示该领域第一名。
数据来源:中国信通院 MCP-Universe 大模型基准测试
ChatGPT、DeepSeek 等主流大模型以云端服务运行:用户的问题和数据需要通过网络发送到远程服务器处理。本地大模型则安装并运行在用户自己的电脑或本地工作站上,可以离线使用,数据无需上传到第三方服务器——这让本地模型在数据隐私、使用成本和长期连续工作上,具备云端模型难以替代的优势。
StartLux(上海原点星辉科学技术有限公司)是全球第一家主打本地模型的 AI 公司,致力于让 AI 运行在每个人的设备上——数据留在本地,能力属于个人。CEO 陈大年是中国初代程序员,曾创立盛大网络、连尚网络;CTO 为郭权玮博士。团队正稳步推进模型训练,并对扩散式语言模型等新架构持续研究。
StartLux 把数据隐私、自主控制和长期运行成本放在首位,优势可以归纳为三点:一是隐私安全,数据留在本地,不出你的设备;二是 token 自由,不再按调用次数付费,长期使用成本可控;三是可长期持续工作,适合离线、内网隔离和需要不间断运行的 agent 场景。本地模型还能在数据所在的设备上直接理解本地文件、邮件与知识库等。我们相信,只有让每个人以安全、低成本的方式与 AI 深入交流,AI 才能真正助力工作与生活——这也是我们走向 AGI 的路径。
在工信部中国信通院人工智能研究所的大模型基准测试——MCP 专项测试中,StartLux-V1.0-27B-Preview 综合得分 39.25,排名第二:超过 284B 的 DeepSeek-V4-Flash 和 198B 的 Step-3.7-Flash,与 1.6 万亿参数的 DeepSeek-V4-Pro 相差仅约1个百分点;位置导航任务排名第一,浏览器自动化、金融分析等任务与 DeepSeek-V4-Pro并列第一或独占第一。这代表StartLux已经具备与优秀云端大模型一致,长期稳定可靠的运行任务的能力。这也意味着,27B 的本地模型,能力已经进入万亿级云端模型的区间。
StartLux-V1.0-27B-Preview 以 Qwen3.6-27B 为基座进行后训练定向增强,依靠团队自主设计的多维度、可验证、可规模化的模型优化升级技术。训练过程中,团队采用“AI 训练 AI”(Auto Research)的方法,自主开展训练实验,并通过反馈持续优化训练策略。这是国内首个采用该方法进行后训练的本地 Agent 模型。
StartLux-V1.0-27B-Preview 能在消费级个人电脑上运行:目前只需 16GB 以上显存的显卡(如 RTX 4060 Ti 16G、RTX 4090、RTX 5090),或 Apple 芯片的高内存版本。具体门槛以正式发布时的兼容设备说明为准,我们也在持续推进更低显存设备的消费级适配。
按照《生成式人工智能服务管理暂行办法》,面向公众提供服务的大模型在首次发布时需先完成备案。StartLux-V1.0-27B-Preview目前正在积极进行备案工作。
现阶段,我们仅在封闭、受控的测试环境中,向少量特定受邀人员(如开发者、媒体、投资人等)开放限量测试通道,用于模型能力验证和技术反馈收集,暂不开放公众注册或公开申请。待相关备案工作完成后,我们将另行公布正式开放安排。您可以在“测试页面”填写信息提交测试申请。
模型计划在完成审核后开源,目前暂无收费计划,后续计划以 StartLux 官方公告为准。
无论是投资、合作还是加入我们,欢迎与 StartLux 联系。